 |
© Иван Рощин, Москва
| ZXNet | : 500:95/462.53 |
| : bestview@mtu-net.ru | |
| WWW | : http://www.ivr.da.ru |
(«Радиомир. Ваш
компьютер» 10/2001)
Дата последнего редактирования: 26.11.2002.
При написании программы для работы с текстовыми файлами мне надо было учесть, что они могут быть в одной из двух кодировок: ALT (так называемая альтернативная кодировка) или WIN (кодировка русской версии Windows). Указывать кодировку каждого текстового файла вручную не хотелось, и я решил реализовать в программе автоматическое определение кодировки. Итак, спешу поделиться результатами своих исследований!
Коды русских букв, как известно, расположены во второй половине кодовой таблицы. Посмотрим, как различаются кодировки ALT и WIN (для удобства показаны только русские буквы):
|
|
Что мы видим? Коды Е0h—EFh, и только они, в обеих кодировках соответствуют русским буквам, — но разным: для ALT это буквы «р»—«я», а для WIN — буквы «а»—«п».
Теперь вспомним, что в тексте на русском языке различные буквы встречаются с разной частотой (табл. 3). Этим мы и воспользуемся для определения кодировки текста.
| Буква | Частота встречи, % | |
|---|---|---|
| о | 10,92 | **************************************** |
| а | 8,89 | ********************************* |
| е | 8,10 | ****************************** |
| н | 6,43 | ************************ |
| и | 6,39 | *********************** |
| л | 5,87 | ********************** |
| т | 5,76 | ********************* |
| с | 5,11 | ******************* |
| к | 4,57 | ***************** |
| р | 4,16 | *************** |
| в | 3,65 | ************* |
| м | 3,08 | *********** |
| д | 3,06 | *********** |
| у | 3,03 | *********** |
| п | 2,71 | ********** |
| ь | 2,32 | ******** |
| ы | 2,12 | ******** |
| з | 2,00 | ******* |
| я | 1,88 | ******* |
| г | 1,69 | ****** |
| ч | 1,67 | ****** |
| б | 1,55 | ****** |
| й | 1,19 | **** |
| ш | 1,01 | **** |
| ж | 0,92 | *** |
| х | 0,84 | *** |
| ю | 0,33 | * |
| ц | 0,29 | * |
| щ | 0,26 | * |
| э | 0,14 | * |
| ф | 0,06 | |
| ъ | 0,03 | |
Пусть c1, c2 — два байта из диапазона Е0h—EFh. В кодировке ALT им соответствуют буквы a1 и a2, в кодировке WIN — w1 и w2. Частоты встречи этих букв в некотором «среднем» тексте — f(a1), f(a2), f(w1) и f(w2).
Выберем c1 и c2 так, чтобы в кодировке ALT буква, соответствующая c1, встречалась чаще, чем буква, соответствующая c2 (т.е. f(a1) > f(a2)), а в кодировке WIN, напротив, буква, соответствующая c1, встречалась реже, чем буква, соответствующая c2 (т.е. f(w1) < f(w2)).
Тогда для определения кодировки достаточно подсчитать, сколько раз в тексте встретится байт c1 (обозначим это число n(c1)) и сколько раз — c2 (обозначим это число n(c2)). Если n(c1) > n(c2), будем считать, что текст в кодировке ALT, иначе — в кодировке WIN. При равенстве n(c1) и n(c2) будем выбирать кодировку случайным образом, с равной вероятностью ALT и WIN.
Очевидно, существует не одна пара (c1, c2), обладающая указанным выше свойством. Какую же из них выбрать, чтобы вероятность правильного определения кодировки была наибольшей?
При определении кодировки возможны четыре различных варианта:
Уменьшив вероятности вариантов 3 и 4, мы тем самым увеличим вероятности вариантов 1 и 2, а значит, повысим надёжность определения кодировки.
Как мы можем уменьшить вероятность варианта 3 (текст в кодировке ALT ошибочно распознаётся как WIN)? Очевидно, для этого разница между f(a1) и f(a2) должна быть как можно большей. Ведь в реальном тексте, кодировка которого распознаётся, частоты букв a1 и a2 не будут точно совпадать с f(a1) и f(a2), и если f(a1) и f(a2) достаточно близки, то легко может случиться так, что в тексте окажется больше букв a2, чем a1, и в результате кодировка будет определена неправильно.
Совершенно аналогично, для уменьшения вероятности варианта 4 разница между f(w1) и f(w2) также должна быть как можно большей.
Итак, мы должны максимизировать величины |f(a1)–f(a2)| и |f(w1)–f(w2)|, или, что то же самое, минимизировать обратные величины. Выберем для этого следующий критерий: сумма квадратов обратных величин должна быть наименьшей.
Переберём (конечно, не вручную, а с помощью специально написанной программы) все возможные пары (c1, c2), удовлетворяющие условиям f(a1) > f(a2) и f(w1) < f(w2), чтобы выбрать из них лучшие в смысле вышеописанного критерия (табл. 4).
| c1, c2 | a1, a2 | w1, w2 |
|
|||||||
|---|---|---|---|---|---|---|---|---|---|---|
| E2h, EEh | т, ю | в, о | 529 | |||||||
| E1h, EEh | с, ю | б, о | 553 | |||||||
| E1h, E5h | с, х | б, е | 782 | |||||||
| E1h, EDh | с, э | б, н | 826 | |||||||
| E2h, E5h | т, х | в, е | 919 | |||||||
| E1h, E8h | с, ш | б, и | 1023 | |||||||
| E1h, EAh | с, ъ | б, к | 1486 | |||||||
| E3h, EEh | у, ю | г, о | 1493 | |||||||
| E2h, EDh | т, э | в, н | 1612 | |||||||
| E3h, EDh | у, э | г, н | 1647 |
Наилучшей парой оказывается (E2h, EEh). Таким образом, если в тексте больше байтов E2h, чем EEh, то считаем, что этот текст в кодировке ALT; если наоборот — в кодировке WIN.
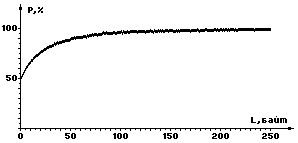
Очевидно, что чем меньше анализируемый текст, тем больше (в среднем) частоты букв a1 и a2 в нём будут отличаться от f(a1) и f(a2) (а частоты букв w1 и w2 — от f(w1) и f(w2)), и тем меньше вероятность правильного определения кодировки (рис. 1).
|
Как видим, при уменьшении длины текста вероятность стремится к 50% — такой же точности мы могли бы добиться, просто определяя кодировку подбрасыванием монетки.
Также понятно, что при уменьшении доли букв «а»—«я» в тексте (скажем, если текст содержит и русские, и английские слова или насыщен псевдографикой) вероятность правильного определения кодировки снижается.
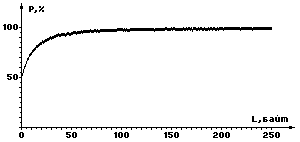
Чтобы её увеличить, можно последовательно определять кодировку по каждой из трёх наилучших пар: (E2h, EEh), (E1h, EEh) и (E1h, E5h), а окончательный результат устанавливать методом голосования (рис. 2).
 |
|
Другие мои статьи об автоматическом определении кодировки текста:
|