© Иван Рощин, Москва
| ZXNet | : 500:95/462.53 |
| : bestview@mtu-net.ru | |
| WWW | : http://www.ivr.da.ru |
(«Радиомир. Ваш
компьютер» 8—11/2005)
Исправленная версия.
Предлагаю вашему вниманию свою программу для поиска и замены последовательностей байтов в файлах. Думаю, такая программа пригодится многим. Вот краткая информация о ней:
Это текстовый файл, длина любой строки которого не должна превышать 1024 символа (определяется константой MAX_STR_LEN в тексте программы).
Содержимое файла следующее:
искомая последовательность 1
 заменяющая последовательность 1
искомая последовательность 2
 заменяющая последовательность 2
................................
искомая последовательность n
 заменяющая последовательность n
Искомая последовательность начинается всегда с начала строки, а перед заменяющей последовательностью обязательно должен стоять пробел. Это служит повышению удобочитаемости файла (сразу видно, какая последовательность на какую заменяется).
Как искомая, так и заменяющая последовательность может состоять из одной или нескольких частей. Если частей несколько, они перечисляются через запятую (без пробела после запятой):
часть_1,часть_2,...,часть_n
Части последовательности могут располагаться и в нескольких следующих друг
за другом строках
часть_1,часть_2,
часть_3,часть_4,часть_5,
........................
часть_31,часть_32
Замечу, что если в нескольких строках располагаются части заменяющей последовательности, то в начале каждой из этих строк (а не только в первой строке) должен стоять пробел.
Каждая часть может быть одной из следующих:
Примеры: 'abcd', "какая-то строка", ``.
Строка не должна содержать символов, которыми она ограничена. Если же надо
записать строку, содержащую все три
Строка не должна содержать символов со следующими кодами: 26
(интерпретируется программой как код конца
Если строка содержит символы с кодом 9 (табуляции), то при чтении
Если строка содержит символы из второй половины кодовой таблицы, то
кодировка
Если строка принадлежит искомой последовательности, то непосредственно
перед открывающей кавычкой можно поставить символ «~»
Чтобы программа могла сравнивать русские буквы без учёта регистра, она
обязательно должна знать кодировку
Кодировка
charset=CP866
charset=Windows-1251
charset=KOI8-R
Тот факт, что кодировка указывается в первой строке
Если кодировка не указана (то есть первая строка не совпадает ни с одной из
трёх вышеприведённых), то программа считает, что
Если в
Примеры: 0, 23, 114.
Примеры: 0x1, 0XaB, 0x38.
Примеры: f"test.wrk", F"d:\data\1.bin".
Примеры: ?, ?????.
Если эти подстановочные символы заданы в искомой последовательности, то каждому из них будет соответствовать любой байт в обрабатываемом файле. Если же они заданы в заменяющей последовательности, то в соответствующей искомой последовательности должно быть задано не меньшее их число; при записи в обрабатываемый файл такой заменяющей последовательности, вместо первого «?» записывается байт, который соответствовал первому «?» в искомой последовательности, и так далее.
Замечу, что символ «?», заданный в строке символов (см. п.1), не имеет отношения к подстановочному символу «?».
Пустая последовательность (т.е. нулевой длины) может быть задана либо как пустая строка (например, ""), либо как ссылка на двоичный файл нулевой длины. Пустой может быть только заменяющая последовательность, но не искомая.
Как видим, одна и та же последовательность может быть задана
различными способами. Ниже показано, как можно
а) "abcdef"
б) 97,98,99,100,101,102
в) 0x61,'',
   "b",99,
   `d`,F"n.bin"   (в файле n.bin — байты 101, 102)
В
Замечу, что поиск и замена происходят так. Вначале текущая
позиция в обрабатываемом файле — это первый его байт. Программа
перебирает все искомые последовательности именно в том порядке, в котором они
перечислены в
Таким образом, если вам надо, скажем, заменить в файле байты 3 на 4, а все
остальные — на 0, то
3
 4
?
 0
А не таким:
?
 0
3
 4
так как тогда все байты заменятся на 0.
Ещё пример. Пусть надо заменить в файле байты 5 на 8, но если после 5
следует 6, то заменять не надо. Тогда
5,6
 5,6
5
 8
При запуске программы надо указать в командной строке сначала, при
необходимости, опцию «/ro» (без кавычек, регистр букв не важен)
для включения режима «read only» («только чтение»), о
котором будет рассказано далее. После этого надо указать два аргумента.
Первый — имя
Второй аргумент — имя файла (возможно, с полным путём к нему), в
котором как раз и будет производиться поиск и замена. Если вы хотите
обработать сразу несколько файлов, то надо создать текстовый файл со списком
этих файлов (в каждой строке указывается имя одного файла, возможно, с полным
путём к нему) и в качестве второго аргумента при запуске программы ввести
символ «@» и сразу за ним — имя
Об автоматическом создании
Несколько примеров командной строки:
mreplace.exe test.ini work.bin
mreplace.exe /RO c:\dos\1.ini e:\progra~1\n.txt
mreplace.exe c:\work\convert.ini @list.txt
mreplace.exe /ro CON @c:\work\list.txt
Замечу, что программа не поддерживает длинные имена файлов, поэтому указывайте короткие имена.
Программа при обработке каждого файла читает информацию из этого файла, производит поиск и замену и записывает результат во временный файл («$$$$$$$$.tmp» — он создаётся в текущем на момент запуска программы каталоге). Когда весь обрабатываемый файл прочитан и его новое содержимое сформировано во временном файле, происходит копирование информации из временного файла в исходный (если произошла хоть одна замена). (Примечание: для ускорения работы программы, при наличии свободной памяти, результат сохраняется в ней, а во временный файл записывается только не уместившаяся в памяти часть результата, если она есть.) Соответственно, на текущем диске должно быть достаточно свободного места для хранения временного файла. В результате произведённых замен размер обработанных файлов может возрасти — следовательно, на дисках с обрабатываемыми файлами также должно быть достаточно свободного места.
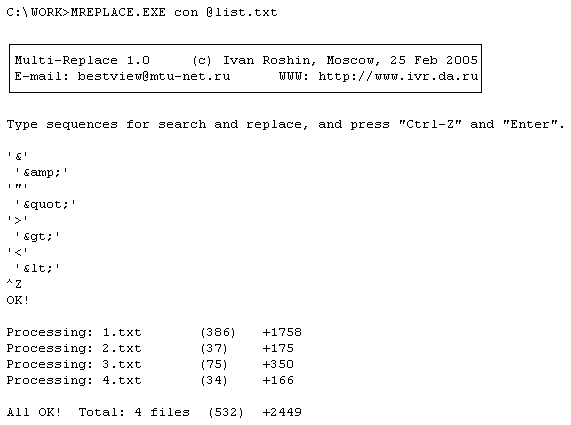
В процессе работы программа выводит для каждого обрабатываемого файла его имя, а после окончания обработки файла выводит рядом с его именем количество произведённых в этом файле замен и разницу между длиной файла после обработки и его исходной длиной (см. приведённый ниже пример сеанса работы с программой). Если все файлы успешно обработаны, программа выводит «All OK!», общее количество обработанных файлов, общее количество замен и разницу между длинами всех файлов после и до обработки, а затем завершает свою работу.
Кстати, если количество обрабатываемых файлов настолько велико, что выводимые программой результаты не умещаются полностью на экране, то можно использовать перенаправление вывода в текстовый файл. Например, если вы хотите перенаправить вывод программы в файл «n.txt», надо просто добавить в конце командной строки « > n.txt» (без кавычек).
Ниже приведён пример сеанса работы с программой.
Теперь расскажу про режим «read only». В этом режиме программа не производит запись на диск (то есть обрабатываемые файлы не изменяются), но выводит информацию точно так же, как если бы они изменялись. Для чего это можно использовать? Например, чтобы узнать, насколько изменится размер файлов в результате обработки, не изменяя сами файлы. Или чтобы узнать, сколько раз встречается некоторая последовательность байтов в некотором файле (файлах): достаточно указать эту последовательность в качестве искомой (заменяющая последовательность не имеет значения), и выводимое программой количество произведённых замен будет требуемым результатом. Кстати, если в качестве искомой последовательности указать подстановочный символ «?», то общее количество замен в обработанных файлах будет равно суммарной длине этих файлов. А если при обработке текстовых файлов в качестве искомой последовательности указать «13,10» (без кавычек), то общее количество замен будет равно количеству строк в этих файлах (конечно, при условии, что строки в этих файлах заканчиваются именно парой байтов 13, 10; также замечу, что если последняя строка файла не заканчивается указанной парой байтов, то она не будет учтена, поэтому результат может быть не абсолютно точным).
Программа возвращает операционной системе код выхода: 0 — успешное завершение, а ненулевое значение свидетельствует об ошибке (сообщение об ошибке выводится на экран). Подробная информация о кодах выхода и ошибках приведена в таблице.
| Код выхода | Выводимое сообщение | Комментарий |
|---|---|---|
| 1 | Syntax: mreplace.exe {options} |
Программа запущена без аргументов или с неправильным их количеством. |
| 2 | Error in “имя файла”: filename too long (line x)! | В указанном |
| 3 | Error: can’t delete temp file! | Ошибка при удалении временного файла. |
| 4 | Error: sequence for replace not found! | Для последней искомой последовательности, указанной
|
| 5 | Error: empty |
|
| 6 | Error: line x too long! | Длина строки x |
| 7 | Syntax error in line x, position y! | |
| 8 | Error: filename too long (line x)! | |
| 9 | Error: too many “?” in sequence for replace (line x)! | |
| 10 | Error: can’t get current directory! | Ошибка при определении текущего каталога. |
| 11 | Error: can’t set directory “x”! | Ошибка при переходе в каталог x. |
| 12 | Can’t open file “имя файла” for read! (или “for write!”). | Ошибка при открытии указанного файла для чтения (или записи). Возможно, такого файла нет или указано длинное имя файла вместо короткого. Если ошибка при открытии файла для записи — возможно, диск с этим файлом защищён от записи или для этого файла установлен атрибут «Read only» («только чтение»). |
| 13 | Close error! | Ошибка при закрытии файла. |
| 14 | Read error! | Ошибка при чтении из файла. |
| 15 | Write error! | Ошибка при записи в файл. Может возникнуть, например, при недостатке свободного места на диске. |
| 16 | Out of memory! | Не хватает места в памяти (программа использует только
«обычную» память — до 640 КБ). Возможно, поможет
освобождение памяти от резидентных программ и драйверов,
без которых можно обойтись. Или, если |
Если вы хотите запустить в многозадачной среде сразу несколько экземпляров программы, убедитесь вначале, что они не будут мешать друг другу, пытаясь обрабатывать одни и те же файлы. Также учтите, что программа в процессе работы создаёт временный файл с фиксированным именем в том каталоге, который был текущим при её запуске, поэтому нельзя, чтобы при запуске разных экземпляров программы текущие каталоги совпадали.
Сказанное в предыдущем абзаце не относится к случаю, когда несколько экземпляров программы запущены в режиме «read only», в котором запись на диск не производится.
Если вам часто приходится последовательно применять несколько
mreplace.exe 1.ini @list.txt
@if errorlevel 1 goto end
mreplace.exe 2.ini @list.txt
@if errorlevel 1 goto end
mreplace.exe 3.ini @list.txt
@if errorlevel 1 goto end
mreplace.exe 4.ini @list.txt
@if errorlevel 1 goto end
mreplace.exe 5.ini @list.txt
@if errorlevel 1 goto end
mreplace.exe 6.ini @list.txt
@if errorlevel 1 goto end
:end
Если файл «mreplace.exe» расположен не в текущем каталоге и не в одном из каталогов, перечисленных в переменной окружения «path» (устанавливаемой в файле «autoexec.bat»), то перед именем файла «mreplace.exe» надо указывать полный путь к нему.
Обратите внимание: в
Если бы
В этом разделе я расскажу, как можно использовать программу для решения некоторых практических задач.
Иногда бывает нужно так обработать текстовый файл, чтобы каждая
строка в нём заканчивалась парой байтов 13, 10 (как принято в DOS и Windows)
независимо от того, как заканчивались строки в исходном файле: парой байтов
13, 10, или одним байтом 13, или одним байтом 10. Вот
13,10
 13,10
13
 13,10
10
 13,10
Программу можно использовать для перекодирования текстовых файлов из одной
кодировки в другую. Сначала расскажу, как можно воспользоваться для этого
большим количеством различных перекодировочных таблиц
/* =============================
     File: "xlt2ini.c"
     Compiler: Turbo C 2.01
 ============================= */

#include <stdio.h>
#include <stdlib.h>

int main (int argc, char *argv[])
{
 FILE *f_xlt, *f_ini;
 int a,b;

 printf ("\nXLT->INI convertor (for Multi-Replace)\n\
(c) Ivan Roshin, Moscow, 21 Mar 2005\n");

 if (argc!=3)
 {
  printf ("\nSyntax: xlt2ini xlt-file ini-file\n\n"); exit (1);
 }

 if ((f_xlt=fopen(argv[1],"rb"))==NULL)
 {
  printf ("\nCan't open xlt-file!\n\n"); exit (1);
 }
 if ((f_ini=fopen(argv[2],"wt"))==NULL)
 {
  printf ("\nCan't open ini-file!\n\n"); exit (1);
 }

 while (a=fgetc(f_xlt), (b=fgetc(f_xlt))!=EOF)
 {
  fprintf (f_ini,"%i\n %i\n",a,b);
 }

 fcloseall();
 exit (0);
}
При запуске этой программы надо указать в командной строке имя
Теперь расскажу о том, как можно перекодировать текст из
кодировки
0x80 0xD0,0x82 0x81 0xD0,0x83 0x82 0xE2,0x80,0x9A 0x83 0xD1,0x93 0x84 0xE2,0x80,0x9E 0x85 0xE2,0x80,0xA6 0x86 0xE2,0x80,0xA0 0x87 0xE2,0x80,0xA1 0x88 0xC2,0x88 0x89 0xE2,0x80,0xB0 0x8A 0xD0,0x89 0x8B 0xE2,0x80,0xB9 0x8C 0xD0,0x8A 0x8D 0xD0,0x8C 0x8E 0xD0,0x8B 0x8F 0xD0,0x8F 0x90 0xD1,0x92 0x91 0xE2,0x80,0x98 0x92 0xE2,0x80,0x99 0x93 0xE2,0x80,0x9C 0x94 0xE2,0x80,0x9D 0x95 0xE2,0x80,0xA2 0x96 0xE2,0x80,0x93 0x97 0xE2,0x80,0x94 0x98 0xC2,0x98 0x99 0xE2,0x84,0xA2 0x9A 0xD1,0x99 0x9B 0xE2,0x80,0xBA 0x9C 0xD1,0x9A 0x9D 0xD1,0x9C 0x9E 0xD1,0x9B 0x9F 0xD1,0x9F |
0xA0 0xC2,0xA0 0xA1 0xD0,0x8E 0xA2 0xD1,0x9E 0xA3 0xD0,0x88 0xA4 0xC2,0xA4 0xA5 0xD2,0x90 0xA6 0xC2,0xA6 0xA7 0xC2,0xA7 0xA8 0xD0,0x81 0xA9 0xC2,0xA9 0xAA 0xD0,0x84 0xAB 0xC2,0xAB 0xAC 0xC2,0xAC 0xAD 0xC2,0xAD 0xAE 0xC2,0xAE 0xAF 0xD0,0x87 0xB0 0xC2,0xB0 0xB1 0xC2,0xB1 0xB2 0xD0,0x86 0xB3 0xD1,0x96 0xB4 0xD2,0x91 0xB5 0xC2,0xB5 0xB6 0xC2,0xB6 0xB7 0xC2,0xB7 0xB8 0xD1,0x91 0xB9 0xE2,0x84,0x96 0xBA 0xD1,0x94 0xBB 0xC2,0xBB 0xBC 0xD1,0x98 0xBD 0xD0,0x85 0xBE 0xD1,0x95 0xBF 0xD1,0x97 |
0xC0 0xD0,0x90 0xC1 0xD0,0x91 0xC2 0xD0,0x92 0xC3 0xD0,0x93 0xC4 0xD0,0x94 0xC5 0xD0,0x95 0xC6 0xD0,0x96 0xC7 0xD0,0x97 0xC8 0xD0,0x98 0xC9 0xD0,0x99 0xCA 0xD0,0x9A 0xCB 0xD0,0x9B 0xCC 0xD0,0x9C 0xCD 0xD0,0x9D 0xCE 0xD0,0x9E 0xCF 0xD0,0x9F 0xD0 0xD0,0xA0 0xD1 0xD0,0xA1 0xD2 0xD0,0xA2 0xD3 0xD0,0xA3 0xD4 0xD0,0xA4 0xD5 0xD0,0xA5 0xD6 0xD0,0xA6 0xD7 0xD0,0xA7 0xD8 0xD0,0xA8 0xD9 0xD0,0xA9 0xDA 0xD0,0xAA 0xDB 0xD0,0xAB 0xDC 0xD0,0xAC 0xDD 0xD0,0xAD 0xDE 0xD0,0xAE 0xDF 0xD0,0xAF |
0xE0 0xD0,0xB0 0xE1 0xD0,0xB1 0xE2 0xD0,0xB2 0xE3 0xD0,0xB3 0xE4 0xD0,0xB4 0xE5 0xD0,0xB5 0xE6 0xD0,0xB6 0xE7 0xD0,0xB7 0xE8 0xD0,0xB8 0xE9 0xD0,0xB9 0xEA 0xD0,0xBA 0xEB 0xD0,0xBB 0xEC 0xD0,0xBC 0xED 0xD0,0xBD 0xEE 0xD0,0xBE 0xEF 0xD0,0xBF 0xF0 0xD1,0x80 0xF1 0xD1,0x81 0xF2 0xD1,0x82 0xF3 0xD1,0x83 0xF4 0xD1,0x84 0xF5 0xD1,0x85 0xF6 0xD1,0x86 0xF7 0xD1,0x87 0xF8 0xD1,0x88 0xF9 0xD1,0x89 0xFA 0xD1,0x8A 0xFB 0xD1,0x8B 0xFC 0xD1,0x8C 0xFD 0xD1,0x8D 0xFE 0xD1,0x8E 0xFF 0xD1,0x8F |
Чтобы получить
0xC0,? '[?]' 0xC1,? '[?]' ...... 0xDF,? '[?]' |
0xE0,?? '[?]' 0xE1,?? '[?]' ....... 0xEF,?? '[?]' |
0xF0,??? '[?]' 0xF1,??? '[?]' ........ 0xF7,??? '[?]' |
0xF8,???? '[?]' 0xF9,???? '[?]' ......... 0xFB,???? '[?]' |
0xFC,????? '[?]' 0xFD,????? '[?]' |
Уже готовые
Возможность перекодирования из
Ещё одна возможная область применения программы, далеко не
очевидная — использование её при переводе периодически изменяемых
текстов. Допустим, у вас есть некоторый текст на русском языке, а надо
подготовить его перевод на английский язык (эти два языка взяты лишь для
примера). При этом вы знаете, что после выполнения перевода исходный текст
будет время от времени изменяться, и все эти изменения надо будет вносить в
перевод. В этом случае могут возникнуть трудности с обеспечением соответствия
исходного текста и перевода. Например, вы внесли
Как же в решении этой проблемы может помочь моя программа? Поясню на
примере. Пусть переводимый текст содержится в файле «1_rus.txt», а
перевод надо сформировать в файле «1_eng.txt». Создадим
Ниже приведён пример
    5.12.2004. Выложена новая статья - "Автоматическое
проставление размеров файлов в HTML-документах".
Описанная в этой статье программа также доступна
в разделе "Программы".
    5 Dec 2004. A new article has been uploaded -
"Automatic Setting File Sizes in HTML Documents."
The program described in the article is also available
in the section "Programs."
    Дополнена и исправлена статья "Расширения файлов
TR-DOS".
    The article "Extensions of TR-DOS Files" has been
supplemented and corrected.
Затем оформим каждый исходный абзац как искомую последовательность, а
каждый переведённый — как заменяющую. Для этого надо заключить
каждую строку в кавычки одного из трёх видов, не встречающиеся в самой строке
(см. раздел «Формат
Для вышеприведённого примера получится следующее:
'    5.12.2004. Выложена новая статья - "Автоматическое',13,10,
'проставление размеров файлов в HTML-документах".',13,10,
'Описанная в этой статье программа также доступна',13,10,
'в разделе "Программы".'
 '    5 Dec 2004. A new article has been uploaded -',13,10,
 '"Automatic Setting File Sizes in HTML Documents."',13,10,
 'The program described in the article is also available',13,10,
 'in the section "Programs."'

'    Дополнена и исправлена статья "Расширения файлов',13,10,
'TR-DOS".'
 '    The article "Extensions of TR-DOS Files" has been',13,10,
 'supplemented and corrected.'
На этом подготовка
copy /y 1_rus.txt 1_eng.txt
mreplace.exe 1.ini 1_eng.txt
Удобство такого способа перевода в том, что при изменении исходного текста
можно не запоминать, где именно производились изменения. Когда надо
подготовить перевод изменённого текста, можно сначала сформировать
переведённый текст с помощью прежнего
После этого остаётся только изменить в
Затем запускаем ещё раз вышеописанный файл «1.bat» и получаем
уже новую версию переведённого текста, соответствующую исходному тексту. Можно
ещё раз проверить переведённый текст, не осталось ли в нём непереведённых
абзацев (вдруг вы
Замечу, что если в нескольких переводимых текстах есть общая часть, то
удобно поместить эту часть и её перевод в отдельный
В процессе работы с программой у вас могут возникать различные вопросы. Да
что там, иногда вопросы возникают даже у меня, хоть я и сам написал эту
программу.
Вопрос. Я точно знаю, что обрабатываемый файл содержит
искомые последовательности, но программа
Ответ. Вот некоторые возможные причины:
Посмотрите также следующие вопросы и ответы на них.
Вопрос. Мне нужно заменить в файле некоторые
последовательности, содержащие русские буквы (эти последовательности заданы в
Ответ. Скорее всего, не совпадают кодировки
Вопрос.
Ответ. Скорее всего, в первой строке
Вопрос. Мне нужно заменить в файле все последовательности
«x???», где «???» — любые байты, на
«y???», где «???» — те же байты, что
соответствовали «???» в заменяемой последовательности. Я создал
следующий
'x???'
 'y???'
Но программа не выполняет замену. Почему?
Ответ. Как я уже упоминал в разделе «Формат
'x',???
 'y',???
Вопрос. Мне нужно заменить «News» на
«Новости», а «News Archive» — на
«Архив новостей». Я создал для этого такой
'News'
 'Новости'
'News Archive'
 'Архив новостей'
Но при его использовании не происходит замена «News
Archive» на «Архив новостей», как если бы соответствующая
пара последовательностей вообще не была описана в
Ответ. Потому что перебор искомых последовательностей происходит
именно в порядке их перечисления в
'News Archive'
 'Архив новостей'
'News'
 'Новости'
Вопрос. Мне надо заменить в текстовом файле последовательность, в которой есть несколько пробелов подряд, но программа не выполняет эту замену. Почему?
Ответ. Скорее всего, причина в следующем. В текстовом файле
последовательность пробелов не всегда бывает представлена именно пробелами
Возможен такой выход из положения: преобразовать файл, заменив в нём все табуляции на эквивалентное число пробелов (это можно сделать, скажем, с помощью Dos Navigator, используя встроенный редактор), а потом уже выполнять замену.
Вопрос. У меня есть текстовый файл в кодировке
Ответ. Да, можно
Интересно, что при создании программы возможность обработки текстов в
кодировке
Вопрос. А нет ли
Ответ. Попробуйте воспользоваться программой «sed».
Существуют её версии для различных операционных систем. Информацию об этой
программе можно найти, например, на сайте http://sed.sourceforge.net. Лично я
пользуюсь расширенной версией «sed» под названием
Кстати, сразу укажу на принципиальное различие между моей программой и «sed»: у меня все замены выполняются за один проход, а в «sed» при выполнении каждой команды, обрабатывающей текущий фрагмент текста, происходит новый проход по этому фрагменту.
Вопрос. А если мне надо производить поиск и замену с использованием регулярных выражений не только в текстовых файлах, но и в двоичных?
Ответ. Тогда попробуйте использовать Perl (www.perl.com). Ниже для примера приведена
#!/usr/bin/perl -w

use strict;

my $c; # Содержимое обрабатываемого файла.
my $n; # Количество выполненных замен.

open (F,'<','test.bin') || die ("Can't open file! $!");
binmode (F);
sysread (F,$c,(-s F)) || die ("Read error! $!");
close (F) || die ("Close error! $!");

$n=($c=~s/[\x00-\x1F]/\x2E/g); # Непосредственно замена.

open (F,'>','test.bin') || die ("Can't open file! $!");
binmode (F);
syswrite (F,$c) || die ("Write error! $!");
close (F) || die ("Close error! $!");

print ('Выполнено замен: ',$n+0);