 |
© Иван Рощин, Москва
| ZXNet | : 500:95/462.53 |
| : bestview@mtu-net.ru | |
| WWW | : http://www.ivr.da.ru |
(«Радиомир. Ваш
компьютер» 1—3/2004)
Исправленная версия.
Много лет назад для хранения
А как вообще можно хранить на бумаге большой объём
Так, на рис. 1 вы можете увидеть, как при этом будет выглядеть
исполняемый файл моей программы Text Corrector, размер которого —
848 байтов (6784 бита). Он представлен в виде
|
Вычислим, сколько информации (в мегабайтах) может уместиться на одной странице формата A4 (210x297 мм), если печать производится с разрешением 600 dpi (т.е. 600 точек на дюйм — один дюйм равен 25,4 мм):
| 210*297*(600/25,4)2 | ~= | 4,15 МБ. |
| 223 |
Немало! Сравним это с тем объёмом информации, который умещается на одной
странице при печати обычного,
Ну как, ещё не упали со стула? :–) А теперь подумаем, почему же
такой способ хранения информации не используют. Точнее — может,
Так в чём же дело? Видимо, есть у этого способа
В общем, я решил изложить здесь свои соображения по поводу этого способа,
рассматривая его с разных сторон. Может быть,
При использовании дискет,
|
|
Таким образом, прочитанное со сканера изображение придётся дополнительно обработать, чтобы извлечь записанную информацию. А для этого надо знать, как именно искажается изображение при печати и последующем сканировании, и разработать специальный алгоритм, восстанавливающий исходное изображение.
Замечу, что имеет смысл архивировать исходные данные перед печатью, чтобы уменьшить их размер. На это будет затрачено некоторое время, но зато сократится расход бумаги и красителя, уменьшится время печати и последующего сканирования (в итоге даже можем получить выигрыш во времени).
Выше упоминалось, что при печати с разрешением 600 dpi на странице можно уместить 4,15 МБ информации. Но всегда ли это значение достижимо на практике? Очевидно, нет. При печати, может быть, принтер не позволит использовать абсолютно всю площадь листа. Не каждый принтер может печатать с высоким разрешением. При печати точки могут расплываться, так что при последующем сканировании (даже с высоким разрешением) разобрать напечатанное уже не удастся. Фактическое максимальное разрешение печати зависит от многих факторов: от конкретной модели принтера, от используемой бумаги, от используемых чернил (для струйного принтера), от используемого тонера (для лазерного принтера) и, возможно, даже от температуры и влажности воздуха. :–) Только экспериментально можно проверить, с каким разрешением можно печатать, сохраняя разборчивость каждого пиксела.
Объём полезной хранимой информации уменьшается ещё и по той причине, что бумага — недостаточно надёжный носитель, чтобы пренебречь возможными ошибками при его использовании. Если, например, на бумаге попадётся тёмное пятнышко — это будет означать уже несколько ошибочных пикселов. Или лист бумаги может быть повреждён уже после печати (например, если он был сложен пополам — впоследствии при сканировании пикселы, расположенные в районе сгиба, могут быть прочитаны с ошибкой; или если лист намок, а потом высох и покоробился).
Чтобы обнаруживать ошибки, придётся хранить контрольные суммы (CRC) записанных данных. А если мы хотим ещё и автоматически исправлять ошибки, придётся хранить избыточную информацию для их исправления. Как именно формировать эту избыточную информацию и какой объём она займёт по сравнению с полезной информацией — отдельный вопрос, зависящий от количества и характера ошибок, которые предполагается исправлять.
Вроде бы понятно, что существует ограничение: разрешение сканера
должно быть не меньше разрешения, с которым было напечатано изображение, иначе
в одном пикселе получаемого при сканировании изображения будет суммироваться
яркость нескольких пикселов напечатанного изображения, и восстановить
напечатанное изображение не получится. А нельзя ли
Известны алгоритмы (например, описанные в [1]),
позволяющие за счёт наличия нескольких различных изображений
То есть теоретически достаточно несколько раз выполнить сканирование одного и того же напечатанного изображения, каждый раз немного сдвигая лист бумаги, а затем обработать полученные изображения с помощью такого алгоритма, чтобы повысить разрешение. Так, на рис. 3 вы можете видеть четыре изображения буквы «A» с низким разрешением и полученное на их основе изображение с более высоким разрешением (опять же замечу, что исходные четыре изображения я получил не в результате реального сканирования, а с помощью специальной программы; результирующее изображение, впрочем, честно рассчитывалось по первым четырём).
 |
+ |  |
+ |  |
+ |  |
= |  |
Далее я попробую рассказать о ситуациях, когда бумага может в
Хранить данные на бумаге может быть дешевле по сравнению с дискетами (конечно, речь идёт о неизменяемых данных, иначе дискеты выгоднее за счёт их повторного использования). Так что, может быть, вы захотите сэкономить на дискетах, пусть и не так удобно возиться с бумагой. По крайней мере, я бы не отказался хранить часть своих данных, к которым сравнительно редко приходится обращаться (например, архивные копии), именно таким образом.
Кстати, стоимость печати информации на бумаге можно уменьшить за
счёт использования… уже использованной бумаги!
Пусть мы имеем ненужный лист бумаги с напечатанным на нём текстом. При этом закрашена, как правило, лишь небольшая часть площади листа. При описании картриджей для принтеров обычно указывается, на печать какого количества страниц их хватит, из расчёта 5% заполнения страницы. Так что за основу можно взять это значение.
Тогда, если считать, что в печатаемом изображении количество белых и чёрных пикселов одинаково, то лишь 2,5% пикселов окажутся ошибочными. В самом деле, ошибки будут возникать лишь на белых пикселах, которые при печати попали на уже закрашенный участок бумаги и потом прочитались как чёрные. А если чёрный пиксел при печати попадёт на уже закрашенный участок бумаги, это не приведёт к ошибке.
Зная характер возникающих ошибок, можно разработать формат с избыточной информацией, позволяющий исправлять эти ошибки. Естественно, избыточной информации придётся добавлять больше, чем при печати на чистом листе, но, как мне кажется, не очень много по сравнению с объёмом полезной информации.
Попробуем оценить величину избыточности кода, необходимую для исправления ошибок, возникающих при печати на уже использованной бумаге. Как известно, в теории информации доказывается, что любому конечному уровню помех соответствует определённая величина избыточности кода, являющаяся необходимой и достаточной для того, чтобы вероятность правильного приёма сообщений была как угодно близка к единице.
Считаем, что в кодируемом сообщении поровну нулей и единиц, 0 кодируется белым пикселом, а 1 — чёрным, относительное количество уже имеющихся на бумаге чёрных пикселов равно k (т.е. вероятность того, что печатаемый пиксел попадёт на уже имеющийся на бумаге чёрный пиксел, равна k), и все другие источники ошибок отсутствуют.
Величина необходимой избыточности кода равна потере информации при передаче сообщения. В [6] потеря информации обозначается Hy(x) и приводится формула для её вычисления:
| Hy(x) = – |  |
pi | |
pi(j) log pi(j), |
| (i) | (j) |
| где | pi | — | вероятность принять сообщение i, |
| pi(j) | — | условная вероятность того, что было передано сообщение j, если принято сообщение i. |
Если в качестве единицы потери информации принять бит, то основание логарифма в этой формуле должно равняться двум.
Рассмотрим потерю информации при передаче одного бита. В нашем случае p0 (вероятность приёма 0) будет равна 0,5*(1–k), а p1 (вероятность приёма 1) равна 0,5*(1+k).
Если был принят 0 — значит, точно был передан 0, т.е. p0(0)=1 и p0(1)=0. Если же был принят 1, то вероятность того, что был передан 0, равна k/(1+k), а вероятность того, что был передан 1, равна 1/(1+k), т.е. p1(0)=k/(1+k) и p1(1)=1/(1+k).
На рис. 4 показана зависимость Hy(x) от k при изменении k от 0 до 1.
 |
При k=0,05 (т.е. когда на бумаге уже имеется 5% чёрных пикселов) потеря информации при передаче одного бита равна примерно 0,145 бита. То есть при передаче одного бита теоретически можно передать 1–0,145=0,855 бита полезной информации (а 0,145 бита — это будет избыточная информация, необходимая для исправления ошибок при передаче). Иными словами, за счёт добавления избыточной информации придётся увеличить размер передаваемых данных в 1/0,855~=1,17 раза.
Правда, теория не даёт ответа на вопрос, каким именно образом надо кодировать данные, чтобы исправлять все ошибки при таком уровне избыточности. Утверждается лишь, что такой код существует.
Итак, при печати на уже использованной бумаге сводятся к нулю
расходы на бумагу и одновременно решается проблема утилизации использованной
бумаги. :–) С другой стороны, я не знаю: возможно, печать на уже
использованной бумаге может повредить
Продолжу рассказ о возможных преимуществах бумаги.
Дискеты не в такой степени надёжны, как хотелось бы. Иногда вроде бы без видимой причины «не читается» один или несколько секторов, и происходит потеря информации. Наверно, каждый сможет вспомнить такие случаи. А при хранении информации на бумаге, как мне кажется, можно достичь большей надёжности за счёт автоматического добавления избыточной информации, позволяющей восстановить записанные данные даже при их повреждении.
Да, при записи на дискету тоже можно добавлять избыточную информацию
(например, упаковав данные RAR’ом с установленной соответствующей
опцией). Но об этом должен заботиться сам пользователь, и далеко не все
пользуются этим. К тому же избыточная информация, добавленная к файлам, не
поможет, если
Для записи
При записи данных на
Справедливости ради отмечу, что при записи
Может быть,
Можно представить ситуацию, когда надо передать информацию с
одного компьютера на другой, но традиционные способы по
И ещё одна немаловажная проблема — моральное старение носителей информации и устройств для чтения этих носителей. Легко ли сейчас найти компьютер с дисководом 5,25"? Нет? А значит, нелегко и прочитать информацию, записанную на таких дискетах. Через несколько лет ситуация может повториться и с дискетами 3,5": уже сейчас производители выпускают компьютеры без этих дисководов. Вполне возможно, та же судьба ожидает и другие используемые в настоящее время носители информации.
А для чтения информации с бумажных носителей не нужно никаких специальных
устройств, кроме сканера. Возможно, в будущем сканеры будут выглядеть не так,
как сейчас (опять же, см. [3]), но исчезновения их,
С помощью сканера и сейчас можно было бы без особого труда прочитать информацию, скажем, с перфокарты. Надо только знать, каким образом эта информация была закодирована. Замечу, что при печати информации на бумаге можно автоматически печатать на том же листе бумаги и инструкцию (на естественном человеческом языке) по «расшифровке» напечатанной информации.
Кстати, печать может производиться и типографским способом, при
этом каждая копия будет очень дешёвой. Сейчас к некоторым книгам, журналам
прилагают
В моих статьях, публикуемых в этом журнале, часто не приводятся исходные
тексты программ —
Вроде бы понятно, что при этом для хранения информации потребуется дополнительный объём бумаги, что также удорожит издание. Но можно… вообще не использовать дополнительно ни одного квадратного сантиметра бумаги и вместе с тем хранить нужную информацию. Как?
Если текст печатается не на белом фоне, то информацию можно
хранить непосредственно в фоне текста. Допустим, фон должен быть
|
|
При этом, если в исходных данных 0 и 1 расположены в целом равномерно (а если исходные данные получены в результате архивации, то примерно так и будет), то получившийся фон не будет заметно отличаться от исходного (если и будут заметны некоторые неравномерности цвета фона, чтению текста это не помешает). Но теперь в фоне уже хранится «наша» информация, и при сканировании можно будет её извлечь.
Разумеется, при этом придётся обязательно использовать избыточную информацию, так как часть пикселов фона перекрывается пикселами текста, и закодированная в них информация будет потеряна (впрочем, как я уже упоминал, пикселы текста обычно составляют небольшую долю от всей площади страницы). Другой вариант — заранее учесть, какие пикселы фона будут перекрыты текстом, и не использовать их для хранения информации, а при сканировании различать функции пикселов по их цвету: если пиксел белый или жёлтый, то он относится к фону и несёт информацию, а если пиксел чёрный — значит, это пиксел текста (но это годится только для цветного фона).
В случае
 |
Допустим, надо получить изображение, как на рис. 6, но поместить в фон
некоторую информацию, количество 0 и 1 в которой примерно равно и они
перемешаны
 |
Каждому чёрному пикселу фона ставим в соответствие один бит кодируемой информации, а потом те пикселы, которым соответствуют нулевые биты, делаем не чёрными, а белыми (рис. 8).
 |
В результате общий оттенок фона заметно не изменится по сравнению с рис. 6, так как соотношение белых и чёрных пикселов в среднем останется тем же самым.
Поверх полученного фона накладываем изображение текста (рис. 9).
 |
Ещё одна идея использования фона для хранения данных возникла у меня под влиянием публикации [4]. Если чёрные пикселы фона, расположенные в узлах регулярной сетки, находятся на достаточно большом расстоянии друг от друга (промежуток между двумя соседними пикселами по вертикали, горизонтали и диагонали — не менее двух пикселов), то можно сделать так: сдвинуть каждый чёрный пиксел фона на один из восьми соседних пикселов (рис. 10) либо оставить его на месте.
 |
Как при этом изменяется фон, показано на рис. 11.
 |
Каждому чёрному пикселу фона будут соответствовать девять возможных вариантов его расположения. Таким образом, каждый такой пиксел будет нести log29~=3,17 бита информации.
При этом ещё и обеспечивается общая однородность фона (отсутствие заметных светлых или тёмных участков), какие бы данные ни кодировались, — потому что количество чёрных пикселов не меняется, а меняются только их координаты, причём не более чем на 1 по каждому направлению.
Если исходное расстояние между чёрными пикселами фона больше двух пикселов, то можно сдвигать пикселы и на большую величину. При этом у каждого пиксела будет больше возможных положений и, соответственно, он будет нести больше информации.
Теперь попробуем рассмотреть ещё одну интересную проблему. Вот вы печатаете данные: бит 0 представлен белым (незакрашенным) пикселом, бит 1 — чёрным (закрашенным). Если вы сами платите за израсходованный краситель (чернила, тонер, красящая лента), то получается, что чёрный пиксел обходится вам дороже белого. Тогда имеет смысл так перекодировать данные, чтобы уменьшить количество чёрных пикселов (пусть даже за счёт увеличения количества белых пикселов — они ведь дешевле), и таким образом сократить стоимость печати данных.
Приведу пример. Пусть чёрный пиксел стоит в три раза дороже белого. Здесь и далее будем считать, что в исходных данных каждый бит с одинаковой вероятностью равен 0 или 1 (если исходные данные получены в результате архивации, то примерно так и будет).
Примем цену белого пиксела за 1 у.е., тогда цена чёрного — 3 у.е. В среднем нулей в данных столько же, сколько единиц, и при обычном способе печати цена записи одного бита составит (1+3)/2=2 у.е.
А теперь перекодируем исходные данные, заменяя каждые два бита так, как показано ниже:
00 -> 1 01 -> 01 10 -> 001 11 -> 000 |
Так как в исходных данных в среднем поровну комбинаций 00, 01, 10 и 11, то в среднем два бита исходной информации будут закодированы в (1+2+3+3)/4=2,25 бита, из них нулей будет (0+1+2+3)/4=1,5, а единиц — (1+1+1+0)/4=0,75.
Тогда средняя цена записи двух битов исходной информации после перекодирования равна 1,5*1+0,75*3=3,75 у.е. Средняя цена записи одного бита, соответственно, вдвое меньше и равна 1,875 у.е — меньше первоначальных 2 у.е.
(Замечу, что вышеописанное кодирование не является идеальным: как мы увидим дальше, теоретический минимум цены записи одного бита при данном соотношении цен белого и чёрного пикселов равен примерно 1,81 у.е.)
Итак, в чём же суть проблемы? В том, чтобы узнать, как при заданном соотношении цен белого и чёрного пикселов надо перекодировать исходные данные, чтобы стоимость их записи была наименьшей. По идее, аналогичная проблема должна рассматриваться в теории передачи информации (если время передачи 1 по каналу связи больше времени передачи 0 и надо добиться наименьшего времени передачи данных). Но информации о её решении я не нашёл (не знаю — может, плохо искал), поэтому привожу собственные размышления на эту тему.
Пусть чёрный пиксел в k раз дороже белого (k>1). Как уже упоминалось выше, считаем, что в исходных данных каждый бит с одинаковой вероятностью равен 0 или 1. Пусть мы имеем наилучший (идеальный) для данного k перекодировщик исходных данных, т.е. обеспечивающий в среднем минимальную цену записи одного бита исходной информации после перекодирования (обозначим эту цену C). Как именно работает этот перекодировщик, мы пока не знаем, но это сейчас неважно.
Пусть доля нулей в перекодированных данных в среднем равна x (каждый бит перекодированных данных равен 0 с вероятностью x и равен 1 с вероятностью 1–x). Очевидно, что x>0,5, так как уменьшить C можно только за счёт относительного увеличения количества нулей в данных.
Также очевидно, что размер перекодированных данных будет в среднем больше размера исходных данных. Это следует из того, что количество информации после перекодирования должно сохраниться, а если после перекодирования нулей стало в среднем больше, чем единиц, то каждый бит перекодированных данных будет содержать менее одного бита информации, а значит, для хранения того же количества информации, что было в исходных данных, понадобится больше битов.
Попробуем вычислить x. Средняя цена записи одного бита перекодированных данных (обозначим её C') равна x*c0+(1–x)*c1, где c0 — цена белого пиксела, c1 — цена чёрного пиксела. Теперь определим, сколько битов перекодированных данных будут содержать столько же информации, сколько её содержит один бит исходных данных (а он и содержит один бит информации).
Информационная ёмкость одного бита перекодированных данных (обозначим её H) равна –(x*log2x+(1–x)log2(1–x)). При x>0,5 H<1. Для записи одного бита информации, следовательно, потребуется 1/H битов перекодированных данных (больше одного бита).
Из вышесказанного следует, что C=C'/H=(x*c0+(1–x)*c1)/–(x*log2x+(1–x)log2(1–x)). Так как c1/c0=k (по определению), то, если принять c0=1 (как мы увидим далее, x не зависит от c0), получим:
| C = – | x+(1–x)*k | . |
| x*log2x+(1–x)log2(1–x) |
Так как C минимальна (по условиям задачи), для определения x достаточно найти минимум вышеприведённой функции C(x). Значение x, при котором достигается минимум, и будет искомым. Минимум можно искать либо численным методом, либо попробовать вывести формулу (приравнять нулю производную функции C(x) и решить полученное уравнение — но этот способ я не пробовал).
На рис. 12 приведены графики функции C(x) при k=1,2,3,4,5. Минимумы отмечены красными точками. Видно, что лишь при k=1, то есть когда цена белого пиксела равна цене чёрного, выгодным является равная доля нулей и единиц в перекодированных данных (то есть можно их вообще не перекодировать). А с ростом k доля нулей в перекодированных данных также должна возрастать, чтобы C была минимальной.
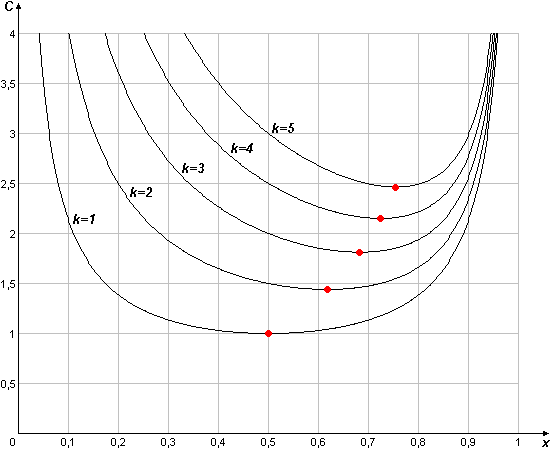 |
Значения x, при которых достигается минимум C, и соответствующие минимальные значения C приведены в табл. 1. Также там приведён получаемый выигрыш от перекодирования — на сколько процентов дешевле получается запись информации (т.е. на сколько процентов минимальное C меньше, чем C(0,5)).
| k | x | C | Получаемый выигрыш |
|---|---|---|---|
| 1 | 0,50 | 1,00 | 0,0% |
| 2 | 0,62 | 1,44 | 4,0% |
| 3 | 0,68 | 1,81 | 9,3% |
| 4 | 0,72 | 2,15 | 14,0% |
| 5 | 0,75 | 2,46 | 17,8% |
На рис. 13 вы можете увидеть график зависимости x от k при изменении k от 1 до 10.
 |
Итак, мы смогли определить некоторые характеристики идеального перекодировщика: среднюю долю нулей в перекодированных данных (отсюда легко находится и среднее соотношение нулей и единиц в перекодированных данных) и среднюю цену записи одного бита исходных данных после перекодирования. Таким образом, при разработке своего перекодировщика мы получили возможность ориентироваться на эти характеристики.
Далее я приведу две различных идеи перекодирования.
Первая идея: построить префиксный код с соотношением 0 и 1, близким к теоретически оптимальному. Исходные данные будем кодировать группами по n битов (чем больше n, тем лучше), для чего построим дерево с 2n листьями. Строим дерево сверху вниз, и при каждом разветвлении выбираем соотношение количеств листьев в двух получающихся поддеревьях (с вершиной 0 и с вершиной 1) так, чтобы оно было возможно ближе к теоретически оптимальному соотношению (и, конечно, чтобы получилось хотя бы по одному листу в каждом поддереве). Поэтому и выгоднее брать большое n — тогда соотношения будут более близки к оптимальным.
Я не располагаю каким-либо доказательством того, что полученный по этому алгоритму префиксный код будет лучшим из всех возможных префиксных кодов для данного n.
Интуитивное обоснование алгоритма следующее: так как каждая развилка в
дереве соответствует одному биту для
Продемонстрирую работу алгоритма на примере. Пусть k=3, тогда x~=0,68 (см. табл. 1), отсюда отношение количества нулей к количеству единиц должно быть равно примерно 2,13. Пусть n=4, т.е. кодируем группами по четыре бита.
Четыре бита — значит, в дереве будет 16 листьев. Разбиваем их на две части так, чтобы количество листьев в первой части относилось к количеству листьев во второй части возможно ближе к 2,13. Получаем 11 листьев в первой части и 5 во второй. Таким образом, в поддереве с вершиной 0 будет 11 листьев, а в поддереве с вершиной 1 — 5 листьев. Итак, первый уровень дерева будет выглядеть следующим образом:

Второй уровень. Аналогично разбиваем 11 на 7 и 4, а 5 — на 3 и 2:

Третий уровень. Разбиваем 7 на 5 и 2, 4 — на 3 и 1, 3 — на 2 и 1, 2 — на 1 и 1:

Четвёртый уровень. Разбиваем 5 на 3 и 2, 2 — на 1 и 1, 3 — на 2 и 1:

Пятый уровень. Разбиваем 3 на 2 и 1, 2 — на 1 и 1:

Шестой уровень. Разбиваем 2 на 1 и 1:

Дерево построено, теперь произвольным образом (так как вероятности всех комбинаций в исходных данных одинаковы) сопоставляем 16 комбинаций с 16 полученными кодами — например, так:
0000 -> 000000 0001 -> 000001 0010 -> 00001 0011 -> 00010 0100 -> 00011 0101 -> 0010 0110 -> 0011 0111 -> 01000 1000 -> 01001 1001 -> 0101 1010 -> 011 1011 -> 1000 1100 -> 1001 1101 -> 101 1110 -> 110 1111 -> 111 |
Количество нулей во всех 16 кодах — 44, единиц — 25. Соотношение 44/(44+25)~=0,64, что достаточно близко к теоретически оптимальному ~0,68. В среднем на кодирование четырёх битов надо затратить 44/16=2,75 нулей и 25/16=1,5625 единиц. Тогда цена четырёх битов — 2,75+3*1,5625=7,4375 у.е. Цена одного бита в четыре раза меньше и примерно равна 1,86 у.е. А если бы мы не перекодировали данные — цена была бы равна 2 у.е.
Вторая идея перекодирования — использовать арифметическое сжатие «наоборот». Известно, что если в исходных данных соотношение 0 и 1 отличается от 1:1, то можно сжать их с помощью арифметического метода. Размер сократится, а нулей и единиц станет примерно поровну. А у нас обратная ситуация: имеются исходные данные, где нулей и единиц примерно поровну (по условиям задачи), а надо получить данные большего размера, но с заданным соотношением нулей и единиц. Тогда можно считать исходные данные упакованными арифметическим методом и распаковать их, получив нужное соотношение 0 и 1 (а размер вырастет). При чтении же — наоборот, сжимаем считанные данные, и в результате получаем исходные данные. Вот такая идея. На практике не проверял. :–)


