|
|
В этой статье рассматривается первая версия программы Pseudographic table –> HTML table convertor. Последняя версия этой программы, исправленная и улучшенная по сравнению с первой версией, доступна в разделе «Программы».
© Иван Рощин, Москва
| ZXNet | : 500:95/462.53 |
| : bestview@mtu-net.ru | |
| WWW | : http://www.ivr.da.ru |
(«Радиомир. Ваш компьютер» 5—7/2003)
При подготовке материалов для своей
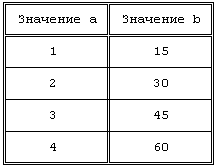
Объясню на примере, что за задачу надо решить. Пусть у нас имеется
текстовый файл, в котором есть таблица, изображённая на рис. 1, а нам
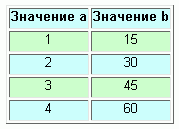
надо, чтобы эта таблица выглядела в итоговом
|
|
Для этого нужно сформировать следующий
<table align=center border=1>
<tr bgcolor=#ccffff align=center>
<th>Значение a</th>
<th>Значение b</th>
</tr>
<tr bgcolor=#ccffcc align=center>
<td>1</td>
<td>15</td>
</tr>
<tr bgcolor=#ccffff align=center>
<td>2</td>
<td>30</td>
</tr>
<tr bgcolor=#ccffcc align=center>
<td>3</td>
<td>45</td>
</tr>
<tr bgcolor=#ccffff align=center>
<td>4</td>
<td>60</td>
</tr>
</table>
Формированием соответствующего
Мне хотелось сделать серьёзную программу, мощную и универсальную. В результате всех усилий получилась программа со следующими возможностями:
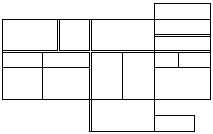 |
Сравнительно легко придумать, как распознавать и преобразовывать в HTML простые таблицы, форма которых полностью определяется путём задания всего двух параметров: количества строк и столбцов (как на рис. 1). Значительно более трудной задачей является распознавание и преобразование в HTML таблиц сложной формы (как на рис. 3). Решение этой задачи, по существу, и было самым сложным при создании программы.
Об используемом алгоритме, который уверенно справляется с таблицами самой сложной формы, я и собираюсь здесь рассказать.
На первом этапе происходит просмотр исходного текстового файла, определение строк текста, подлежащих дальнейшему анализу, и построение списка этих строк. В программе этим занимается функция def_text_hl.
Список строк текста (strings) представляет собой массив, каждый элемент которого описывает одну строку и содержит смещение от начала файла, по которому находится эта строка, и длину строки (с учётом символов табуляции).
При анализе текста отбрасываются строки, не содержащие псевдографических символов, используемых для изображения таблиц. Когда в тексте встречается одна или несколько идущих друг за другом таких строк, то в список строк просто добавляется элемент, соответствующий пустой строке (длина которой равна нулю), — только чтобы отделить друг от друга строки с псевдографикой, расположенные до и после отброшенной группы строк.
Максимальное количество элементов в списке строк ограничено числом 5000 (определяется константой MAX_STRINGS). Но за счёт того, что строки текста, точно не относящиеся к таблицам, отбрасываются, в исходном тексте может быть и больше 5000 строк.
Итак, мы имеем список, в котором содержится информация о строках исходного текста, подлежащих дальнейшему анализу, и о добавленных пустых строках. Совокупность описанных в этом списке строк будет представлять собой текст, подлежащий дальнейшему анализу.
Для дальнейшей работы с этим текстом удобно представить его следующим
образом.
Реально в программе текст, подлежащий дальнейшему анализу, нигде специально не хранится и никаких манипуляций с ним не производится. Вместо этого имеется функция getc_xy, позволяющая получить символ этого текста по его координатам x и y. Эта функция использует описанный выше список строк текста и исходный текстовый файл.
Ошибочные ситуации, которые могут возникнуть на первом этапе:
Распознавать всю таблицу сразу — слишком сложно, так как таблица может быть самой странной формы. Поэтому распознавание таблиц начинается с более простой задачи — распознавания отдельных ячеек.
Что мы знаем о ячейках? Каждая ячейка ограничена псевдографической рамкой прямоугольной формы, причём для изображения каждого элемента ячейки могут использоваться только определённые псевдографические символы (табл. 1).
| Элемент ячейки | Псевдографические символы, которые могут использоваться для его изображения |
|---|---|
| левый верхний угол | 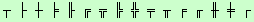 |
| верхняя сторона |  |
| правый верхний угол | 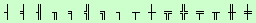 |
| правая сторона |  |
| правый нижний угол | 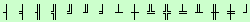 |
| нижняя сторона |  |
| левый нижний угол | 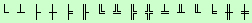 |
| левая сторона |  |
Для каждого элемента ячейки в программе имеется своя функция (check_left_up, check_up, …, check_left), определяющая, может ли подаваемый на вход символ быть использован для изображения этого элемента (то есть содержится ли этот символ в соответствующей строке табл. 1).
Распознаванием ячеек занимается функция find_all_cells. Для всех i от 0 до text_l–2 и для всех j от 0 до text_h–2 она проверяет (с помощью функции check_cell), имеется ли в тексте ячейка, левый верхний угол которой находится по координатам (i,j). Если да, то координаты этой ячейки (т.е. координаты её левого верхнего и правого нижнего угла) заносятся в массив cells.
При распознавании ячеек текст просматривается слева направо и сверху вниз. Соответственно, в таком же порядке в массив cells помещается информация о ячейках.
Ошибочные ситуации, которые могут возникнуть на втором этапе:
Если второй этап завершился успешно, количество обнаруженных ячеек печатается на экране.
Пусть в анализируемом тексте имеются, например, такие две таблицы (рис. 4). Номера в ячейках показывают, в каком порядке они хранятся в списке ячеек, который был сформирован на втором этапе.
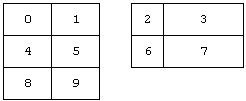 |
Это нам с вами при взгляде на рисунок сразу становится понятно, что там две таблицы, что ячейки с номерами 0, 1, 4, 5, 8 и 9 принадлежат первой таблице, а ячейки с номерами 2, 3, 6 и 7 — второй таблице. Но компьютер этого пока ещё «не знает». В его распоряжении — только список ячеек, где для каждой ячейки указаны её координаты.
На третьем этапе как раз и определяется, какая ячейка какой таблице принадлежит, и выясняется общее количество таблиц в тексте (какой бы сложной формы они ни были).
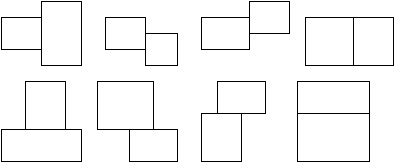
Так как таблица представляет собой связную совокупность ячеек, то от любой ячейки таблицы можно перейти к любой другой через смежные ячейки. Две ячейки считаются смежными, если они имеют общую сторону или её часть (рис. 5). В программе имеется специальная функция (smezhn), определяющая, являются ли две ячейки смежными, с помощью сравнения их координат.
 |
Таким образом, зная любую ячейку, принадлежащую таблице, можно, переходя от одной ячейки к другой и помечая ячейки, в которых уже побывали, выявить все ячейки, принадлежащие этой таблице.
Тогда логика действий такова: берём из списка ячеек первую ячейку и
считаем, что она принадлежит первой таблице. Выявляем все ячейки,
принадлежащие первой таблице. Затем берём из списка ячеек первую из оставшихся
ячеек и считаем, что она принадлежит второй таблице. Выявляем все ячейки,
принадлежащие второй таблице. Эти шаги повторяются до тех пор, пока для всех
ячеек не будет установлена принадлежность к
На основе примера, изображённого на рис. 4, рассмотрим, как эти действия осуществляются в программе.
В списке ячеек для каждой ячейки, кроме координат, хранится номер таблицы, к которой эта ячейка принадлежит. Вначале для всех ячеек там число 255 — оно обозначает, что номер таблицы неизвестен (а если известен — там будет число от 0 до 254, т.е. всего в тексте может быть не более 255 таблиц).
В функции find_all_tables берётся первая ячейка из списка (т.е. с номером 0 — и ячейки, и таблицы нумеруются с 0) и считается, что она принадлежит таблице 0. Чтобы установить для всех ячеек, принадлежащих этой таблице, соответствующий номер, вызывается функция find_table (на вход подаётся номер таблицы и номер ячейки, принадлежащей этой таблице).
Рассмотрим, как работает функция find_table. Вначале для ячейки, указанной при вызове (в данном случае 0) устанавливается соответствующий номер таблицы (тоже 0), и номер этой ячейки заносится в стек. Возникшая при этом ситуация изображена на рис. 6; штриховкой на этом и следующих рисунках помечаются ячейки, для которых уже установлена принадлежность к таблице.
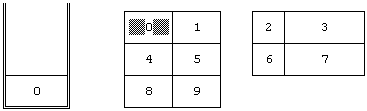 |
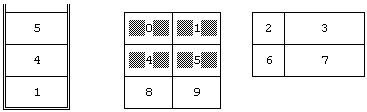
Далее начинается цикл, который будет выполняться, пока стек не опустеет. Из
стека извлекается верхнее значение (в данном случае 0) и находятся все ячейки,
для которых ещё не установлена принадлежность к
 |
Стек организован с помощью массива с количеством элементов, равным максимальному количеству ячеек (MAX_CELLS), так что он не может переполниться.
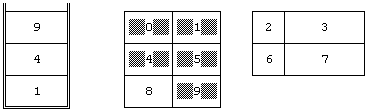
При следующем выполнении цикла картина будет такой (рис. 8).
 |
И далее (рис. 9):
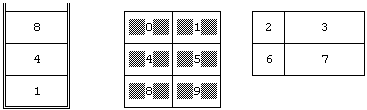 |
При дальнейших выполнениях цикла со стека будут сниматься номера ячеек 8, 4, 1, но, так как для всех смежных с ними ячеек уже установлена принадлежность к таблице, новых значений в стек помещаться не будет. В результате стек опустеет и цикл завершится. На этом работа функции find_table закончится.
Происходит возврат в функцию find_all_tables. Переменная all_tables (количество найденных таблиц), изначально равная 0, увеличивается на 1. Далее делается попытка найти в списке ячеек ячейку, которая не принадлежит никакой таблице. В данном случае это ячейка 2.
Опять вызывается функция find_table со следующими параметрами: номер таблицы — 1, номер ячейки, которая принадлежит этой таблице, — 2. Подробно рассматривать то, что происходит при втором вызове этой функции, я здесь не буду.
После завершения работы функции find_table опять выполняется увеличение all_tables на 1 и проверяется, не найдётся ли в списке ячейка, не принадлежащая никакой таблице. В данном случае нет — следовательно, задача выполнена. На этом работа функции find_all_tables завершается.
Найденные таблицы оказываются пронумерованы, исходя из следующего принципа: слева направо и сверху вниз. Так происходит потому, что при каждом поиске ячейки, не принадлежащей никакой таблице, список ячеек просматривается от начала к концу, а в этом списке ячейки расположены как раз в порядке «слева направо, сверху вниз».
Ошибочные ситуации, которые могут возникнуть на третьем этапе:
Если третий этап завершился успешно, количество обнаруженных таблиц печатается на экране.
Это финальный этап, на котором происходит построение
Рассмотрим действия, которые выполняются при выводе каждой таблицы.
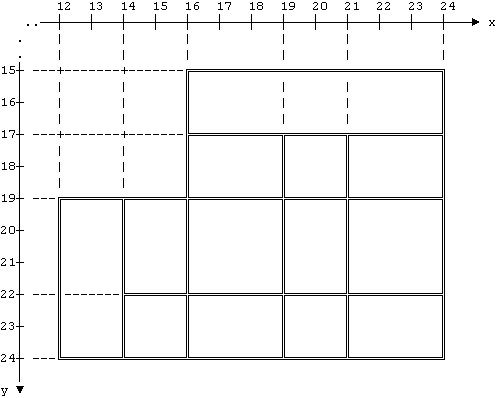
Сначала происходит переход от физических координат ячеек таблицы
 |
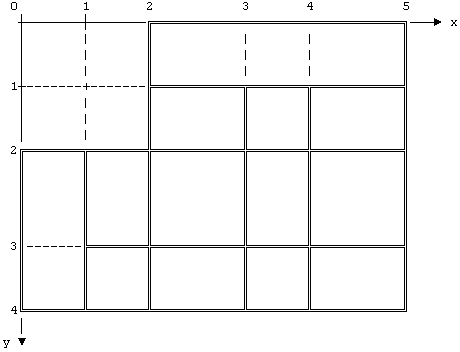 |
В программе этим занимается функция make_log_xy. Она заносит физические
log_x: 12, 14, 16, 19, 21, 24.
log_y: 15, 17, 19, 22, 24.
Эти массивы как раз и используются для перехода от физических координат к логическим и наоборот. Чтобы определить логическую координату по физической, достаточно отыскать в массиве элемент, значение которого равно физической координате, тогда индекс этого элемента будет логической координатой. Обратный переход ещё проще: значение элемента с индексом, равным логической координате, и будет равно искомой физической координате. Элементы массивов, напомню, нумеруются с 0.
Количество элементов массива log_x (в данном случае 6) — это
количество различных
Итак, физические координаты ячеек таблицы преобразованы в логические. Что происходит дальше? Язык HTML рассчитан на описание прямоугольных таблиц, поэтому, если таблица не является прямоугольной, к ней добавляются пустые ячейки, чтобы дополнить её до прямоугольной. В программе этим занимается функция make_space_cells. Она формирует список добавляемых пустых ячеек (space_cells) и определяет их количество (all_space).
Ячейки добавляются так, чтобы по возможности минимизировать их количество
(а значит, и размер выходного
В данном случае к таблице будет добавлена одна пустая ячейка с логическими координатами левого верхнего и правого нижнего углов соответственно (0,0) и (2,2).
И, наконец, с помощью этих данных происходит формирование
Таблица выводится по строкам сверху вниз (количество строк уже известно — log_h–1). При этом используется список ячеек исходной таблицы (cells) и добавленных пустых ячеек (space_cells). В каждой строке ячейки выводятся слева направо.
Рассмотрим вывод одной строки.
В указанных двух списках с помощью функции find_cell отыскивается ячейка с
минимальной
Если логическая ширина ячейки больше 1, то к тегу <td> (или <th>) добавляется атрибут colspan, значение которого равно логической ширине ячейки. Аналогично, если логическая высота ячейки больше 1, добавляется атрибут rowspan.
Содержимое ячейки выводится в выходной файл (чтобы добраться до содержимого, придётся перейти от логических координат ячейки обратно к физическим).
Далее ищется и выводится ячейка со следующей по величине
Ошибочные ситуации, которые могут возникнуть на четвёртом этапе:
Программа написана на Turbo C 2.0. Параметры компиляции должны быть следующими: модель памяти — huge, параметр Jump Optimize должен быть отключён, иначе могут быть ошибки (у меня это проявлялось в том, что при отладке некоторые строки программы не выполнялись).
Длина листинга программы в распечатанном виде — более 8 метров,
так что привести его в журнале нет возможности. Размер исполняемого файла
программы — примерно 15 КБ, так что его дамп тоже не получится
привести. Но вы можете скачать эти файлы (а также пример
Входные параметры передаются программе через командную строку следующим образом:
tab2html.exe (имя ini-файла) имя исходного файла имя выходного файла
Имя файла может содержать полный путь к файлу. При указании полного пути символ «\» после имени диска и двоеточия обязательно должен присутствовать. Если путь к файлу не указан, файл считается находящимся в текущем каталоге.
Имя
Если указать имя
Как можно заметить, ситуация, когда при вызове программы имя
Пример вызова программы:
tab2html.exe n.ini e:\text1.txt c:\work\text1.htm
Для этого примера
Исходный текстовый файл должен быть в альтернативной кодировке, с кодами конца строк (13,10) — кроме, может быть, последней строки текста, у которой код конца строки может отсутствовать. Исходный файл может содержать символы табуляции, которые будут правильно обработаны.
Выходной файл формируется также с кодами конца строк (13,10). Кодировка
выходного файла может быть ALT, WIN или KOI — это зависит от
значения параметра Recode, указываемого в
После запуска на экран выводятся сведения о программе:
Затем вы увидите, если всё нормально, примерно следующее (каждая строка соответствует своему этапу выполнения программы; во второй строке указывается количество найденных ячеек, а в третьей — количество таблиц; у вас, конечно, эти значения будут другими):
Pass 1... OK.
Pass 2... OK, found 39 cells.
Pass 3... OK, found 2 tables.
Pass 4... OK.
После этого программа завершит своё выполнение.
Программа возвращает операционной системе код завершения. 0 — признак успешного завершения, ненулевое значение свидетельствует об ошибке (табл. 2). Сообщение об ошибке также выводится на экран.
Если программа была вызвана из
| Возвращаемое значение | Комментарий |
|---|---|
| 1 | Неправильно указаны параметры при вызове программы. |
| 2 | Ошибка при открытии входного файла. |
| 3 | Ошибка при открытии выходного файла. |
| 4 | Ошибка при открытии |
| 5 | Ошибка при чтении параметров |
| 6 | Во входном файле встретилась слишком длинная строка. |
| 7 | Во входном файле слишком много строк, предположительно относящихся к таблицам. |
| 8 | Не найдено ни одной таблицы. |
| 9 | Количество найденных ячеек таблиц превышает максимально допустимое. |
| 10 | Количество найденных таблиц превышает максимально допустимое. |
| 11 | Количество пустых ячеек, добавляемых к одной из таблиц непрямоугольной формы, оказалось больше допустимого. |
| 12 | Ошибка при записи в выходной файл. |
| 13 | Ошибка при закрытии входного файла. |
| 14 | Ошибка при закрытии выходного файла. |
В этом файле задаются параметры, определяющие внешний вид получаемых таблиц и кодировку выходного файла.
Символ «;» в начале строки обозначает, что эта строка является комментарием. Такие строки, а также пустые строки игнорируются.
Общее количество строк и максимальная длина строк в
Ниже приведены описания всех параметров
Для понимания смысла многих параметров необходимо знание языка HTML.
Параметр AttributesTable — атрибуты тега <table>.
Пример
AttributesTable={align=center border=1}
Параметр UseCaption определяет, будет ли у формируемых таблиц заголовок, содержащий номер таблицы. Y — да, N — нет.
Пример
UseCaption=Y
Параметр AttributesCaption — атрибуты тега <caption>.
Пример
AttributesCaption={align=bottom}
Параметры FirstTagsInCaption и LastTagsInCaption определяют теги, которые будут добавлены соответственно после тега <caption> (то есть перед текстом заголовка таблицы) и перед тегом </caption> (то есть после текста заголовка). Может быть указано несколько тегов или вообще ничего не указано.
Пример
Пусть заголовок должен выводиться наклонным шрифтом. В этом случае значения параметров должны быть следующими:
FirstTagsInCaption={<i>}
LastTagsInCaption={</i>}
Параметр TextCaption — содержимое заголовка таблицы.
Пример
TextCaption={Табл. }
Параметр FirstCaptionNum — номер, с которого начнётся нумерация таблиц. Номер таблицы включается в заголовок сразу после текста, заданного параметром TextCaption.
Пример
FirstCaptionNum=1
Параметр AttributesTR — атрибуты тега <tr>. Значением этого параметра может быть либо одна строка, либо число строк (1—255) и далее эти строки. В последнем случае для первого тега <tr> в каждой таблице будут использованы атрибуты, взятые из первой строки параметра, для второго тега <tr> — из второй строки, и так далее (после того, как атрибуты будут взяты из последней строки параметра, произойдёт переход к первой). Это удобно использовать, например, чтобы делать таблицы «полосатыми».
Пример
Пусть надо, чтобы цвет фона в строках таблицы чередовался: в верхней строке — #ccffff, в следующей строке — #ccffcc, потом опять #ccffff, и так далее. Тогда значение параметра будет таким:
AttributesTR=2 {bgcolor=#ccffff} {bgcolor=#ccffcc}
Параметры UpTH и LeftTH показывают, сколько первых строк сверху и первых столбцов слева в каждой таблице будут содержать тег <th> вместо <td>.
Пример
UpTH=1
LeftTH=0
Параметр AttributesTH — атрибуты тега <th>. Значением этого параметра может быть либо одна строка, либо число строк (1—255) и далее эти строки. В последнем случае в каждой строке таблицы для первого тега <th> будут использованы атрибуты, взятые из первой строки параметра, для второго тега <th> — из второй строки параметра, и так далее (после того, как атрибуты будут взяты из последней строки параметра, произойдёт переход к первой).
Пример
Пусть никаких атрибутов задавать не надо. Тогда значение параметра будет таким:
AttributesTH={}
Параметры FirstTagsInTH и LastTagsInTH определяют теги, которые будут добавлены соответственно после тега <th> (то есть перед содержимым ячейки) и перед тегом </th> (то есть после содержимого ячейки). Значением каждого из этих параметров может быть либо одна строка, либо число строк (1—255) и далее эти строки. В последнем случае (на примере параметра FirstTagsInTH, для параметра LastTagsInTH — аналогично) в каждой строке таблицы после первого тега <th> будут добавлены теги, взятые из первой строки параметра FirstTagsInTH, после второго тега <th> — из второй строки, и так далее (после того, как атрибуты будут взяты из последней строки параметра, произойдёт переход к первой).
Пример
Пусть в таблице три столбца и надо, чтобы в
FirstTagsInTH=3 {<i>} {} {}
LastTagsInTH=3 {</i>} {} {}
Параметр AttributesTD — атрибуты тега <td>. Значением этого параметра может быть либо одна строка, либо число строк (1—255) и далее эти строки. В последнем случае в каждой строке таблицы для первого тега <td> будут использованы атрибуты, взятые из первой строки параметра, для второго тега <td> — из второй строки, и так далее (после того, как атрибуты будут взяты из последней строки, произойдёт переход к первой).
Пример
Пусть в таблице три столбца и надо, чтобы в
AttributesTD=3 {align=right} {align=center} {align=center}
Параметры FirstTagsInTD и LastTagsInTD — то же самое, что и описанные выше FirstTagsInTH и LastTagsInTH, но относятся не к <th>, а к <td>.
Пример
Пусть в таблице три столбца и надо, чтобы текст в
FirstTagsInTD=3 {} {<b>} {}
LastTagsInTD=3 {} {</b>} {}
Параметр DelSpaceInCell определяет, надо ли удалять пробелы сверху и снизу, слева и справа от содержимого ячеек. Y — да, N — нет.
Пример
DelSpaceInCells=Y
Параметр UseNbspInSpaceCells определяет, нужно ли добавлять символ « » в пустые ячейки таблицы, чтобы вокруг этих ячеек рисовалась рамка. Y — да, N — нет.
Примечание: параметр не оказывает влияния на пустые ячейки, которые добавляются к таблицам непрямоугольной формы.
Пример
UseNbspInSpaceCells=Y
Параметр Recode — кодировка выходного файла: 0 — ALT, 1 — WIN, 2 — KOI.
Пример
Recode=1
Параметр UseLRaquo определяет, на что будет заменён символ кавычки в содержимом ячеек: если N — всегда на «"», если Y — первый символ в ячейке будет заменён на ««», второй — на «»», следующий — опять на ««» и так далее.
Пример
UseLRaquo=Y
|
Другие мои статьи о создании, обработке или просмотре
|